忆时塔(Chronomem)实测笔记 · 下篇
结果最好看的部分,是「我的测量方法错了」
这是实证论文的博客版——position 论文(AiraXiv 2610.0035)提出评估计划,
上篇 讲那份设计,
本文报告执行结果。评估工具与原始结果归档:
atomgit.com/ystyle/chronomem (bench/与bench/results/)。
上篇讲设计:忆时塔把记忆按时间分层,用「精确回想」(沿引用链下钻,不调 LLM)和「语义回想」(读摘要)两条成本不同的路,占住扁平存储与一次性压缩之间的位置。
这篇讲实测。设计论文以一份评估计划收尾、没有任何结果;我把那个计划执行了。
执行下来最有价值的发现不是忆时塔表现多好,而是测量这件事本身有多容易错——我最初的测量方法错了两次,两次都产出了看起来可信、甚至像是可发表的数字,而且错的方向会把结论整个反转。
一、怎么测的
两份刻意不同的语料
合成 trace。 一个带 seed 的生成器产出 N 个模拟日的 agent 活动:每天产生少量事实(一条带记录结果的决策)加填充活动,另有一组探针问题,问的是更早日子里的事实。三个 seed:7/11/23。
真实部署语料。 我自己那套忆时塔,2026-08-29 起连续跑,单用户。评估时持有 480 条工作日志、1201 条 agent 活动记录、63 条教训记录,工作日志有 37 个天级、6 个周级摘要窗口。这份语料没有标准答案,所以只用于「存活」测量,不测准确率。
五条臂吃同一份输入
| 后端 | 机制 |
|---|---|
flat-recency |
保留全部,但只暴露最近 20 条 |
one-shot-compaction |
每 2 天把历史重写成一份运行简报,丢弃细节 |
chronomem-exact |
沿引用链下钻到原始条目(不调 LLM) |
chronomem-day |
读天级摘要 |
chronomem-week |
读包含该事实的周级摘要 |
五条臂吃同一份 trace、答同一组探针,并由同一个抽取器读取——因为弱抽取器会同等压低所有臂,对照关系得以保全;而每条臂各配一个读取器,就会把「臂的差异」和「读取器的差异」混在一起。
第一版对照缺了一条臂,而且缺得很要命。 最初摘要臂只读天级摘要。可这是一篇主张关乎分层的论文——被命名为「分层」的那一侧只测了一层,而粗层从未被提问过。补上 chronomem-week 之后才看得见:两条摘要臂不是同一测量的两种粒度,天级臂读的是事实所在的窗口(问题与材料范围一致),周级臂读的是覆盖另外六天的窗口(答案是压缩后的若干项之一)。这个不对称恰恰是架构主张的取舍,只有两条臂都在才看得见。
三个把测量做对的前提
开发过程中被测量本身确立的约束,值得单独列出来,因为每一条都曾经让结果失真:
- 答案要按轮转分配,不能均匀随机。 小探针集上均匀抽样会聚集——9 个探针里曾有一个选项占了 7 个,等于给了 78% 的多数类基线,不留任何检出真实差异的余地。轮转把基线压到约 1/选项数。
- 每天的主题不能重复抽。 同一天重复一个主题会让「第 N 天 X 选了什么」变成歧义问题。54 个(天,主题)组合里有 6 个歧义,而它们解释了分层后端每一次失分——系统确实记住了事实,是抽取器取了另一个。
- 探针必须永远回看,且滞后随运行增长。 当天探针会被任何近因窗口答对;固定短滞后同样如此(30 天 trace 上,1 天滞后时 20 条窗口仍得 90.6%)。滞后必须随日号增长,那才是分层存储应当取胜的那条轴。
每个事实在文本里还带一个不透明的引用号(ref ZQ01),摘要会逐字保留它,使抽取无歧义——因为摘要的散文结论惯常把多个主题和多个选项写进一句话。
二、结果一:近因基线的失效是断崖,不是衰减
30 天合成 trace,300 事件、32 探针、三个 seed。先看会丢信息的三条臂——注意近因窗口那条的断崖:
| 滞后(天) | 近因窗口 | 天级摘要 | 周级摘要 |
|---|---|---|---|
| 1 | 100% | 100% | 0% |
| 2 | 0% | 50% | 0% |
| 3–4 | 0% | 25% | 0% |
| 5–6 | 0% | 25% | 0% |
| 7–13 | 0% | 57.1% | 28.6% |
| 14–29 | 0% | 66.7% | 33.3% |
| 整体 | 6.2% | 53.1% | 18.8% |
再看另两条:一次性压缩(两个变体)与精确回想。这条对照是「100 分差距只由对应关系造成」那句话的来源:
| 滞后(天) | 一次性压缩(破坏性) | 一次性压缩(保守) | 精确回想 |
|---|---|---|---|
| 1 | 0% | 100% | 100% |
| 2 | 0% | 100% | 100% |
| 3–4 | 0% | 100% | 100% |
| 5–6 | 0% | 100% | 100% |
| 7–13 | 0% | 100% | 100% |
| 14–29 | 0% | 100% | 100% |
| 整体 | 0.0% | 100.0% | 100.0% |
两条摘要臂是单次运行(单个 seed),每桶探针数只有 2–14 个,所以分桶数字噪声大,整体数更可信。
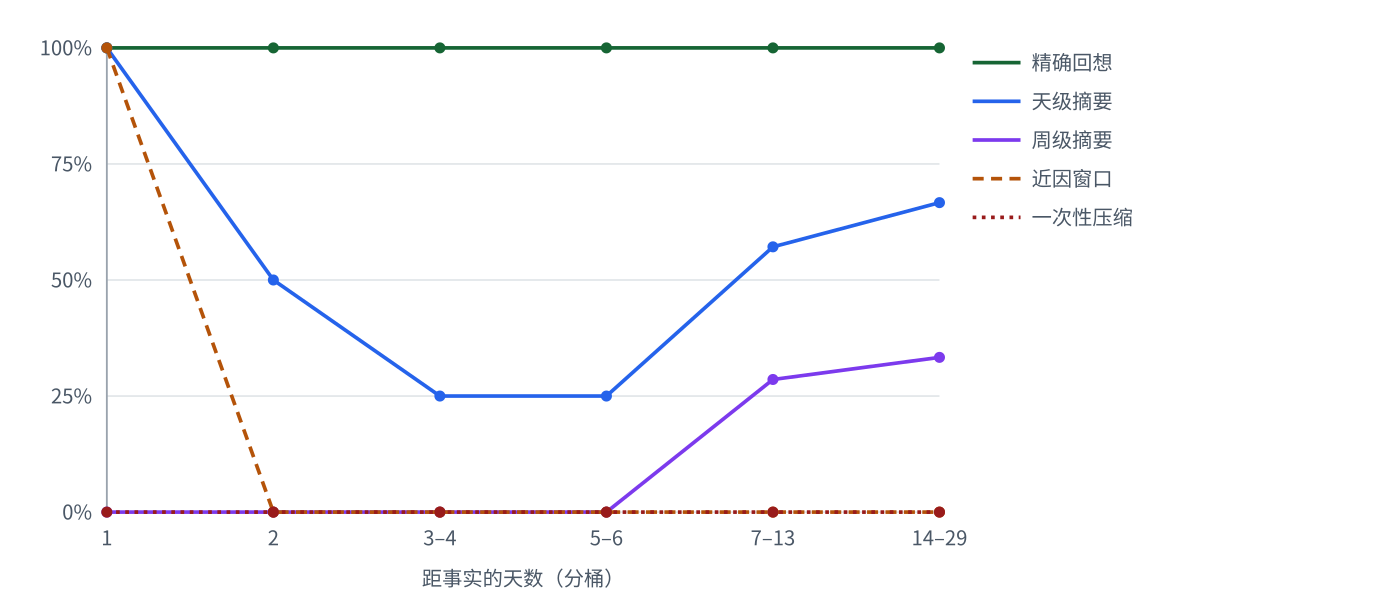
图 1 · 各臂的召回保留率 vs 滞后。精确回想全程平在 100%——它不随事实变老而衰减。近因基线在滞后一天时满分、从第二天起归零,是断崖而非斜坡。一次性压缩在每一档都是零,包括最近的窗口。两条摘要臂会丢信息但非单调下降,因为摘要在生成时即定形、之后不随年龄改变。
三点观察,按「有多出乎意料」递减:
(a)近因基线的跌落是断崖。 滞后 1 天满分,第 2 天起直接归零。窗口容纳 20 条、trace 每天约 10 条事件,边界落在约 2 天处。跨越这条边界时内容本身没有任何变化——那段信息只是不在目标文本里了。
这不是「逐渐遗忘」,是结构性失效。六点消融(下图)显示断崖随容量移动:
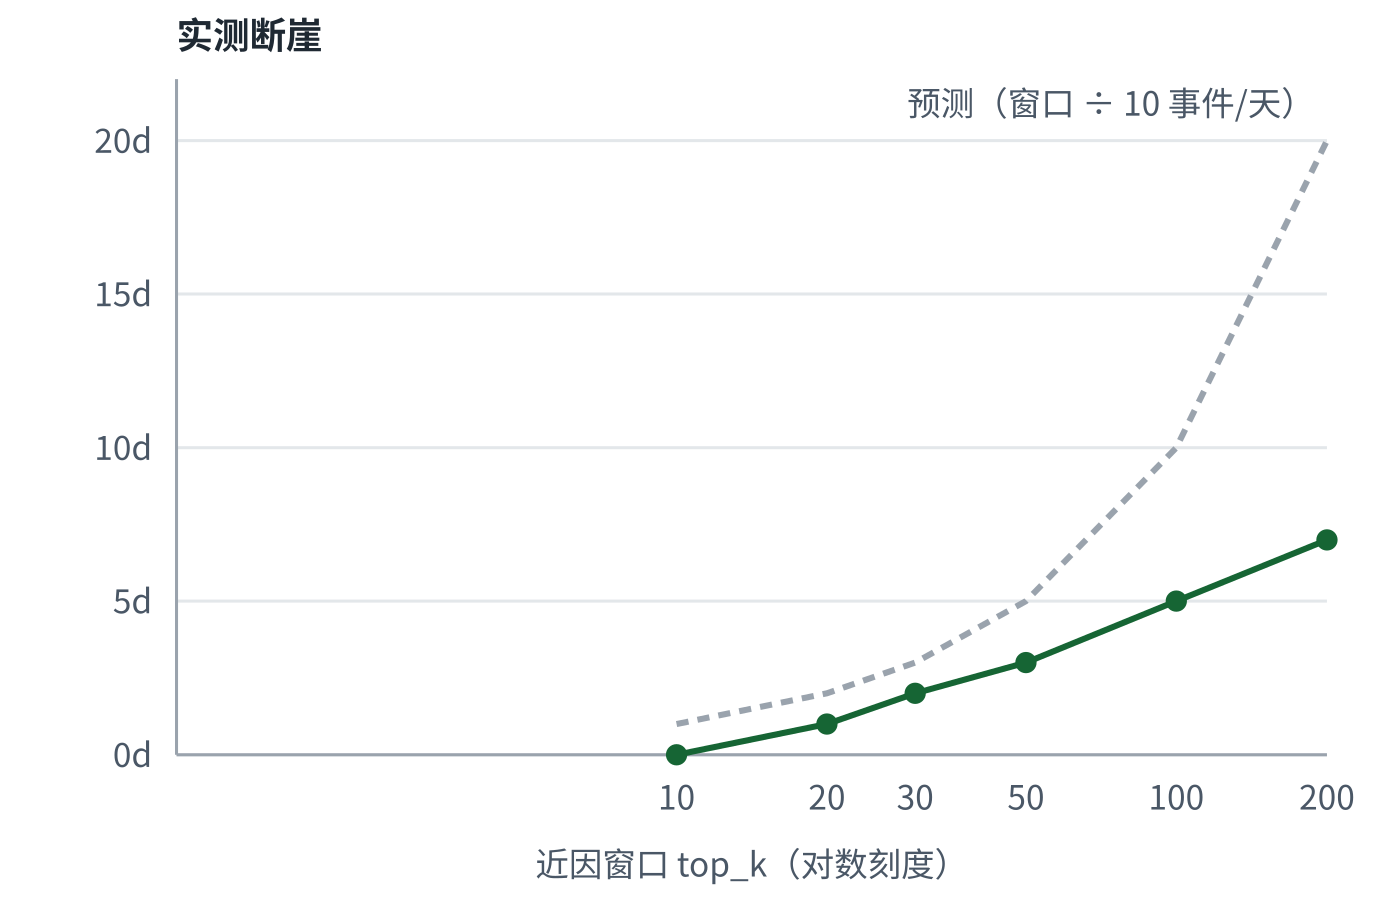
图 2 · 消融:实测断崖随窗口容量移动。灰色虚线是预测——容量为 top_k 条的窗口覆盖 top_k ÷ 10 事件/天 天;绿线是实测。实测略低于预测,因为桶边界稀疏——断崖只能落在边界上,而相邻那一桶要求其中每个探针都答对。
(b)一次性压缩在所有档位都是零——但这个零里有一部分是我自己造成的。 这是对我初稿最尖锐的质疑,而且它说得对:我把压缩器写成把取值转述掉,这个零有我的成分。
为了把两者分开,我加了保守压缩臂:同样的压缩节奏,但保留每一个「引用号→取值」配对,只丢上下文和散文。结果它每一档都是 100%。
也就是说:100 分的差距,只由每问 11 个 token 造成(196 对 185)。压缩里真正承重的,是条目与取值之间的对应关系——转述一旦把这个对应关系拆散,信息就没了,哪怕字数差不多。
(c)分层存储的损失是压缩损失,不是时间衰减。 精确回想每一档都保持 100%,且跨 seed 零方差(六个桶全部 std 0.0)。
而语义回想并不随滞后单调下降——14–29 天的 66.7% 反而高于 3–4 天的 25%。原因很直白:摘要生成一次后不随年龄改变。它丢的是压缩在生成那一刻丢掉的东西;时间不是变量。
补充:统计功效
分桶只有 2–14 个探针,所以我补了 95% Wilson 区间(小样本二项比例的合适区间;正态近似在这些样本量下会给出 [0,1] 之外的界)。以「区间不重叠」为保守判据:
| 对比 | 滞后 1 | 7–13 | 14–29 |
|---|---|---|---|
| 精确 vs 近因 | 重叠 | 不重叠 | 不重叠 |
| 精确 vs 一次性压缩 | 重叠 | 不重叠 | 不重叠 |
| 天级 vs 周级摘要 | 重叠 | 重叠 | 重叠 |
所以「精确回想优于基线」在 7 天以后是统计上站得住的;而「天级优于周级」在当前样本量下站不住。 后者的差异是真实存在的趋势,但不是这个样本量能断言的。
顺带一个量化:同一次总结,两次只有四分之一重合
语义回想的离散度来自 LLM 采样,而且很大。取两个真实生产窗口,把原始条目导入独立实例,各自用 recompute 重新总结 5 次(输入相同、参数相同、温度保持端点默认 0.7):
| 来源窗口(输入规模) | 长度 SD | 版本间平均相似度 |
|---|---|---|
| 2026-09-15(12 条 / 13724 字符) | 265 | 0.263 |
| 2026-09-12(33 条 / 29198 字符) | 437 | 0.250 |
五次输出的具体长度分别是 1789, 1686, 1332, 1205, 1258 与 2350, 1562, 1456, 1432, 2189。
同一窗口的两次总结只有约四分之一的文本重合,而且差异是实质性的——同一天一次写成「权限为 admin-only」,另一次写成「团队权限链路重构(A1/A2)」。
我没有去调低温度,这是刻意的:部署的摘要是无人值守的调度器生成的,冻结温度会让报告的保持率描述一个部署并不使用的配置。
所以摘要的桶均值是宽分布的中心,不是精确值;单次运行的分桶数字只有指示意义。
三、结果二:递归总结的保真度取决于输入多样度
这一节是我错了两次的地方。
我要刻画的这一步是:某项目在一周内的摘要 → 该项目的周摘要。
尝试一:把整天摘要对整周摘要比
保留率算出来 81–84%,暗示粗层几乎无损。
这不是有效比较:一个周包覆盖 5–7 天、比天包长约 3.4 倍,所以它既包含被测当天,又包含另外六天。目标文本更大,某个 token 就更可能因巧合出现——这与压缩无关。
把这个假象推到极端会更明显:在一个「整天 vs 整周」的变体里,它强到让更粗的层级看起来比更细的还保真(数量上 42% 对 29%)。
一个粗层比细层更保真的压缩测量,测的是文本长度,不是压缩。这个结果本该立刻引起怀疑。
尝试二:单独一天 vs 该周的对应项目段
仍然不对等——周段覆盖整周。
尝试三(采用):两侧都限制到同一项目、同一 7 天窗口
这才是递归真正做的变换,因为总结器就是按 group key 聚合某个项目的子摘要。
来自三个已闭合周的 40 个项目-周对:
| 输入天数 | 对数 | 数量保留 | 长度比 |
|---|---|---|---|
| 1 | 29 | 90% | 0.94x |
| ≥2 | 11 | 58% | 0.53x |
| 全部(混合) | 40 | — | 0.82x |
其中「标识符」与「因果连接词」两项:
| 输入天数 | 标识符保留 | 因果连接词保留 |
|---|---|---|
| 1 | 97% | 90% |
| ≥2 | 65% | 48% |
单输入的情形根本不是压缩。
这 29 对里,周摘要与其所依据的天摘要逐字节相同——在 755、1112、972 字符的文本上实测相似度 1.0000。
这点值得停一下:LLM 不可能逐字复现 755 个汉字。所以模型做的事是选择原样复述输入。那里的「90% 保留」意味着「没有发生压缩」,而不是「压缩是无损的」。
压缩只在输入多样时出现,且趋势随输入规模延续:
| 输入天数 | 长度比 | 数量保留 |
|---|---|---|
| 1 | 0.94x | 90% |
| 2 | 0.64x | 66% |
| 3 | 0.15x | 30% |
| 4 | 0.20x | 21% |
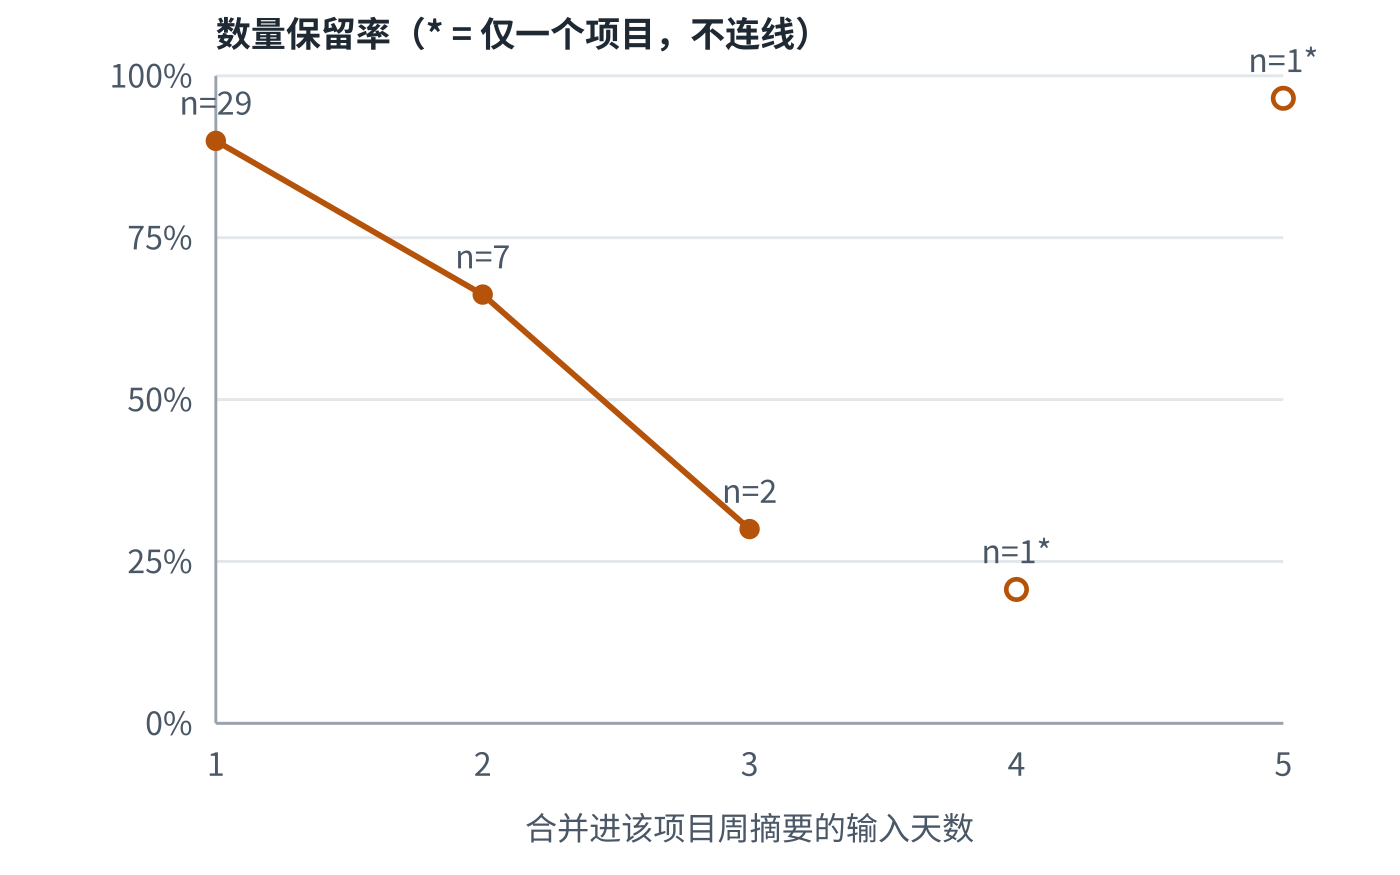
图 3 · 递归步按「被要求合并多少」成正比地损失。数量保留率 vs 合并进该项目周摘要的输入天数。单天点(n=29)接近 100%,因为该步在复述输入而非压缩它;需要合并的天数越多、保留越低。标 * 的点只含一个项目,绘制但不连线,否则单个观测会把曲线带偏。
三条推论
(a)跨输入规模平均会抬高保真度。 把 29 个单输入对混进平均后,长度比从 0.53x 变成 0.82x,表观保真度显著上升。任何对递归总结器的评估都必须按输入多样度分层,否则会把「什么都没做」的那些情形当成成功来报。
(b)两跳差一个数量级。 原始 → 天 压缩 3.1–4.2 倍;天 → 周 只有 0.53 倍。原因不是层级,而是输入:第一跳吃的是原始条目,第二跳吃的是已经被压过一次的摘要。所以「每层压缩比固定为 k」不是这套架构的属性。
(c)这条链不是定点压缩器。 成立的表述是:这条链从不丢失它没被给到的信息,且压缩量正比于输入的多样度。
四、结果三:真实语料上,活下来的是名字
盲测:不走 LLM 也能召回精确事实
设计。 我先自己从工作日志里读出六个事实(一次 OOM 事故的根因与两项修复;一次重试/退避策略变更及其理由;一次产品改名以及有意不改的部分;一处关于两组件关系的文档订正;三天摘要缺失的根因;一次模型 A/B 对照及其 prefill 吞吐)。然后派一个 agent,其唯一信息源是经由 MCP 的记忆服务——不访问仓库、不上网、不用先验知识。
结果:6/6 全对,且全部经由 exact 路径答出(沿引用链下钻,回路中不调用 LLM)。
答出的内容包括精确的操作细节:常驻内存 30–60 MB 对瞬时峰值 217–240 MB、堆上限由 256 MB 提到 1 GB、prefill 吞吐 317 对 267 tok/s,以及改名时有意保留的那几个键及其理由。
这正是上篇那个成本不对称的主张,现在是被测量而非被论证的:单靠无 LLM 路径,就能召回两个月前的具体操作性事实。
一个限定要说清:这只表明被保留下来的那些是可召回的,不表明重要的东西都被记录下来了。
链上先丢什么
同一语料上,最先损失的是量化证据与因果机制;专有名词与标识符存活最久。
- 数量:一次打包清理把清单从 244 个文件收到 101 个。两个数字在天级与周级摘要中都不存在,留下的是「0.4.1 版已发布」。一项下载护栏从 1/3 提到 3/3、峰值 RSS 恒定在 284 MiB;周摘要里
护栏、3/3、284一个都没有。 - 机制:「排序比较器拿一个含
@version的标签当主键,于是版本序退化成字典序」,在两个更粗层级上都只剩**「排序」**这一个词。标识符pkgLabel、@version以及「字典序」全部消失。 - 规则是最脆的:可复用的规则(「改内置函数语义前先查 API 文档」)几乎从不以规则形态存活,只在一条不相干的待办(「同步 docs-site」)里留下痕迹。
两点限定:其一,被用来下结论的数量会被丢掉,而充当状态或验收口径的数量常常存活——所以不是「数字会丢」,而是「证据性的数字会丢」。其二,这个顺序只在真正发生压缩的地方成立。
一个运维层面的发现
这次评估里有一条合成基准不可能产出的证据。
我的周摘要只覆盖了 6 个已闭合周中的 4 个。缺失的两周(09-07、09-14)并非随机缺席:同一时期的一个调度缺陷(compact 条目超出端点的 32768 token 上下文 → HTTP 400 → 失败 → 无限重试)导致总结器有两天产出为零条记录。正常批次在周一 00:10–00:20 生成,那两周从未出现在这个节奏点上。
而由于调度器只总结最近一个已闭合窗口,这个缺口持续存在。补算这两周(对每个窗口显式调一次 mem/summarize)把周覆盖恢复到 6 周,并把链式测量从 0/6 可召回提升到 3/6。
记忆系统自身的一次故障,在它自己的记忆里留下了一个可测量、可持久的缺口——而且缺口的形状(恰好限于故障期、天级摘要完好)反过来指认了成因。
五、方法论:两个陷阱与一个负面结果
这是我最想让人看到的一节。
陷阱一:一个把结论反转的长度假象
现象:把整天摘要对整周摘要比较,得到周层保留率高于天层(数量上 42% 对 29%)。
为什么错:周包长约 3.4 倍、多覆盖六天,某个 token 更可能因巧合而出现。两侧限制到同一项目同一窗口后,顺序就反了过来。
推广:任何在长度与范围不同的文本上算出的保留指标都值得怀疑。破绽是与机制相矛盾的排序——粗层不可能比它的输入更保真。
陷阱二:一个把失败制造出来的抽取歧义
探针原本按(主题,天)定位答案。摘要的散文结论惯常把多个主题与多个选项写进一句话(「keb 与 vun 分别应用了选项 A 与选项 C」),于是「取首个选项字母」的读取器会返回另一个主题的答案——而那个错误答案是貌似合理的,所以看起来不像 bug。
分层后端显示的每一次失分都追溯到这一点。改为逐事实的不透明引用号后,该后端得 100%。
还有个更隐蔽的变体:摘要把一天压成一行是常态,长这样——
- Day 1: ZT02 选方案 B (keb), ZR01 选方案 A (rix)
(注意这一行里塞了两个事实:ZT02→B 和 ZR01→A。)
取段内首个选项的读取器会用 B 回答 ZR01。那个字母是同一段里的合法选项,所以这次失分看起来像「答错了」而不是读取器 bug——而且层级越粗、事实被压得越密,这个假象越强。它让粗层臂在六天以内的每一档都报 0%,而正确选项明明就在文本里。
修法是位置感知的:定位引用号,读它之后的选项(当引用号跟在选项后时,读它之前最近的那一个)。
推广:当某个后端的失败集中在一个答案取值上,或当它们只出现在某一层而正确答案明明就在文本里时——先怀疑读取器,再怀疑系统。
负面结果:LLM 判定者夸大了丢失
判断一个事实是否「存活」在机械上并无定义,所以我请了独立的 LLM 判定者。它们的输出自信而详细。
在我深入核验的具体主张里,两个都错了:
- 判定者称「同一周的周摘要逐字节相同(同一 md5、15796 字符)」
→ ✅ 成立。 - 判定者称「周摘要就是最后一天的天摘要集合」
→ ❌ 推翻——逐日比对只有 0–1 个分组逐字相同。 - 判定者称某天摘要「完全略去了 chronomem 组;整条因果链与全部数字都没了」
→ ❌ 推翻——该组存在且完整,包含根因链与OOM、sseCond、CLOSE_WAIT、心跳等词。
两个被推翻的主张朝同一个方向偏:断言了一个并不存在的缺失。判定者的计数(intact/partial/absent 分布)同样因此不可引用。
判定者仍有一项用处:它们指向了正确的现象——「周输出逐字节相同」这件事是真的,而追查它引出了上一节按输入规模的分析。但方向与数字必须来自机械的重新测量。
这个失效模式会影响任何依赖模型判断「这是否存活」的记忆系统评估:判定者看不见只以摘要形态呈现给它的东西,而不加小心的评估者同样看不见。
一处自我更正
本节初稿曾用「237 与 453 字符」作为采样方差的证据。那个数字来自调用两次 recompute 后比较 mem/recall 的两次返回——但 recall 会把该窗口的全部历史版本按最新在前拼接返回,所以第二次返回是「第一版 + 第二版」,不是第二个样本。
那个数字测的是累积,不是方差。 上文那张 5 次重跑的表才是正确的。
六、我因此依靠什么
上面每一条量化主张,都来自可重新运行、且输出随仓库归档的脚本:带 seed 的 trace 生成器、五臂运行器、消融、token 存活与递归步测量、链式核查。判定者的输出也归档了,但标注为仅作方向参考。
工具本身有 31 个回归用例,外加一个变异检查——它刻意以十一种方式破坏实现(包括上述陷阱),如果测试套件没有察觉就判失败。这些是在踩过那些坑之后补的,理由很简单:
如果测试从未碰到它所声称覆盖的东西,测试通过本身说明不了什么。
七、这份评估没说到的
- 只有三个 seed。 精确回想各桶零方差使其 100% 稳健;摘要数字带高达 38% 的分桶标准差,应读作中心而非点估计。
- 合成 trace 的量级不可迁移。 机制层面的结论(容量断崖、破坏性压缩)可以,具体数字不行。
- 真实语料没有标准答案。 所以那一节是存活测量与盲测召回,不是准确率。
- 只测了
天 → 周这一跳。 服务也支持更细层级(10min/30min/1h/3h),本文未刻画。 - 层级链止于
week。 超出最粗已启用层级的跨度,不是被更粗地总结,而是由exact路径 + 对原始序列翻页覆盖(实测 300 条跨 2 页无截断)。尚未测量的是原始序列长到翻页不再实用的那种跨度——那是部署量级问题,不是总结层级的封顶。 - 单一部署、单用户、约两个月。 未验证多租户、鉴权、加密。
- 压缩只有一种实现。 一次性压缩基线是我自己写的;更强的压缩器会改变它的数字,但不会改变那个结构性论断——它无法回答关于已被它丢弃的内容的问题。