忆时塔(Chronomem)设计笔记 · 上篇
扁平存储与一次性压缩之间,还缺一种记忆
这套设计我写成了 position 论文(AiraXiv 2610.0035),
对应的实证论文是下篇 的主题。
代码与完整技术设计:atomgit.com/ystyle/chronomem 。
本文是博客版,讲动机与设计取舍;严格定义与参考文献见论文。
一个跨周、跨月持续干活的 Agent——迭代一个代码库、写一篇论文、长期维护一个项目——最缺的能力很朴素:记住很久以前发生的事。
今天的外部记忆方案基本分两派,而且它们的失败方式正好相反:
- 扁平存储:全都存下来,按近因或相似度检索。细节保全了,但没有任何压缩——过了几个月,没有任何一层能告诉你「这一阵子大概发生了什么」,除非把全部内容读一遍。
- 一次性压缩:定期把整段历史压成一份报告。压缩有了,但证据毁了——决定被记住了,而「为什么选它、当时怎么做的」这些原始事件没了,且无法重新推导。
忆时塔(Chronomem)想占的是两者中间那块地。我把设计写成了 position 论文,把测量写成了实证论文;这篇讲设计。
一、日常里早就有答案了
这个设计不是我凭空想的——它抄的是两种早就存在的日常机制。
日报体系。 干活的记录 → 日报 → 周报 → 月报。每一层都比下一层简洁,而且每一层都能独立回答「这个尺度上发生了什么」:想知道今天干了啥,看日报;想知道这个月干了啥,看月报,不用把三十天的日报重读一遍。
财务汇总报表。 这个更严格,性质也更值得借:账本永不删除,报表是渐进重算出来的,而且每张报表都能审计回底层分录。报表不是账本的「有损替代」,而是账本之上的一个可再生成的视图。
忆时塔把这两件事工程化到 Agent 记忆上。从报表实践里,我刻意迁移的是纪律而不是聚合语义:
| 纪律 | 在忆时塔里的对应 |
|---|---|
| 明细层不可变 | 原始条目 append-only,永不改写 |
| 可审计的下钻 | 每条摘要都带 refs,沿引用链能走回原始条目 |
| 幂等的渐进重算 | 物化是幂等的,重复跑不会产生第二份 |
这里有个关键差异要说清楚,否则会低估难度:ERP 的合并报表是对结构化分录、按法定固定日历做确定性求和。而这里每一层要用 LLM 去总结任意的 JSON 事件和自然语言记录——汇总本身成了不确定的。粒度链要按记忆类型自己配,而「导航」与「压缩」之间的成本差异,也从实现细节变成了首要的设计变量。
二、塔长什么样
一句话:记忆按时间堆叠成塔,一层一个物化粒度,越久越粗、越久越高。
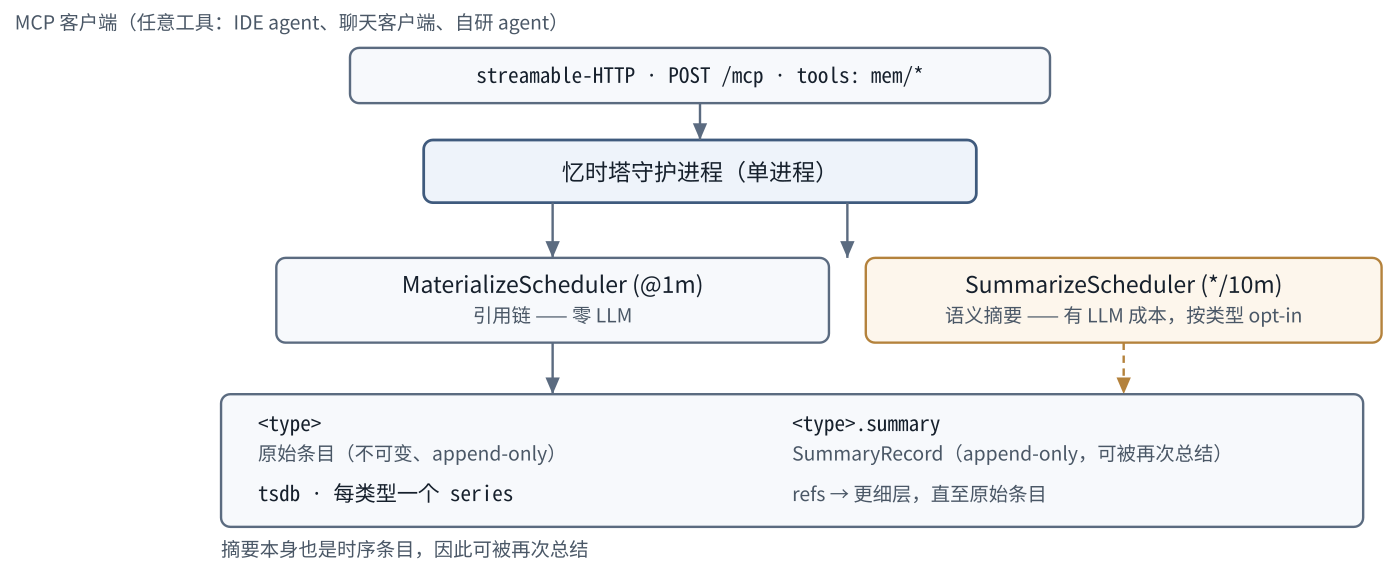
图 1 · 架构。客户端经 MCP 接入单一守护进程;两个独立调度器分别物化一个类型的两个 series——引用链(零成本、分钟级)与语义摘要(有 LLM 成本、按类型 opt-in)。摘要存于自己那条 append-only series,并通过 refs 指向更细层,这正是递归总结得以成立的原因。
粒度链(每个记忆类型可自定义)
    week   ──┐   越久越粗
    day    ──┤
    1h     ──┤
    30min  ──┤
    10min  ──┘   越久越高
       ↑
    原始条目(append-only,永不删除)
每一层同时干两件事:
- 导航结构:持有指向更细层的引用,一路走到底就是原始条目;
- 可选的语义摘要:一眼能读懂「这个尺度上发生了什么」。
粒度从 {10min, 30min, 1h, 3h, day, week, month} 里取,默认 10min → 30min → 1h → day → week。
粒度链是按类型配的,这点很重要。 高频通道(比如 agent 活动流,一分钟好几条)要保留分钟级层级,才能支持「当天内精确回想」;而稀疏通道(比如一天一条的工作日志)用 day → week 就够了——否则会建出大量几乎是空的细桶,白占空间。
week 是默认的语义总结封顶。理由很实在:一整年的周级摘要只有约 52 条,加载便宜,而「回忆一整年」这种需求极少需要更细。
三、核心主张:回想不是一种操作
这是整篇设计的支点。
大部分人把「回忆」当成一个动作:给个查询,返回内容。但我认为这里必须拆成两条成本结构完全不同的路:
| 精确回想 | 语义回想 | |
|---|---|---|
| 做法 | 沿引用链下钻到原始条目 | 读 LLM 生成的窗口摘要 |
| 服务端 LLM | 不调 | 调(生成或读取时) |
| 保真度 | 无损 | 有损(压缩) |
| 返回体量 | 原始体量,不压缩 | 摘要体量,真正变小 |
| 前提 | 无 | 摘要必须已存在 |
第一条路是「导航」,不是「压缩」。 这点很容易被误解,我特意在论文里写死:精确下钻能把粗窗口解析成原始条目,但返回的就是原始体量——它没有让任何东西变小,只是让你能按时间定位。
第二条路才是真正压缩粗窗口的形态,而且它有个硬前提:摘要必须先存在(之前生成过,或者现在花钱生成)。
一个必须说破的成本账
「精确回想不花 token」这句话,只在服务端一侧成立。真实账本是双侧的:
| 服务端 | 客户端 | |
|---|---|---|
| 精确回想 | 不调 LLM | 返回的原始条目要注入 prompt——随体量增长 |
| 语义回想 | 生成/缓存摘要时调 LLM | 注入摘要文本——更小,但非零 |
| 结构物化 | 不调 LLM | 无(客户端根本看不到桶) |
所以精确回想并非「端到端免费」:它把 token 成本转移给了客户端,换来保真;语义回想则是把成本留在服务端,代价是丢细节。
这个区分回头看很平凡,但我认为现有系统把它模糊了,模糊的代价是三个具体问题:
- 触发策略:结构物化(引用链)是每分钟跑、零 token 的作业。语义总结正相反——没有护栏的调度器会在空窗口或低价值窗口上悄悄烧 token,还会对注定失败的窗口反复重试。
- 语义漂移:对摘要再总结很便宜,但会漂移;从原始数据重算保真,但贵。如果这两者不显式暴露,就成了一个静默的质量问题。
- 上下文卫生:服务应该只存和取,永不主动把内容塞回客户端上下文。取多少,由客户端决定。
四、摘要是时序条目,所以可以递归
这是整个设计里我最满意的一点。
mem/summarize 读一个窗口(按粒度+锚点,或按显式 from/to 处理「任务阶段」这种不规则窗口),让 LLM 产出结构化摘要——固定几个锚点章节:决策 / 结论 / 待办 / 状态变更 / 关键词——然后追加一条 SummaryRecord 到该类型的 .summary series。
关键在于:这条摘要是追加到一条时序 series 里的,和原始条目一样是一等公民。
于是它能被再次总结:
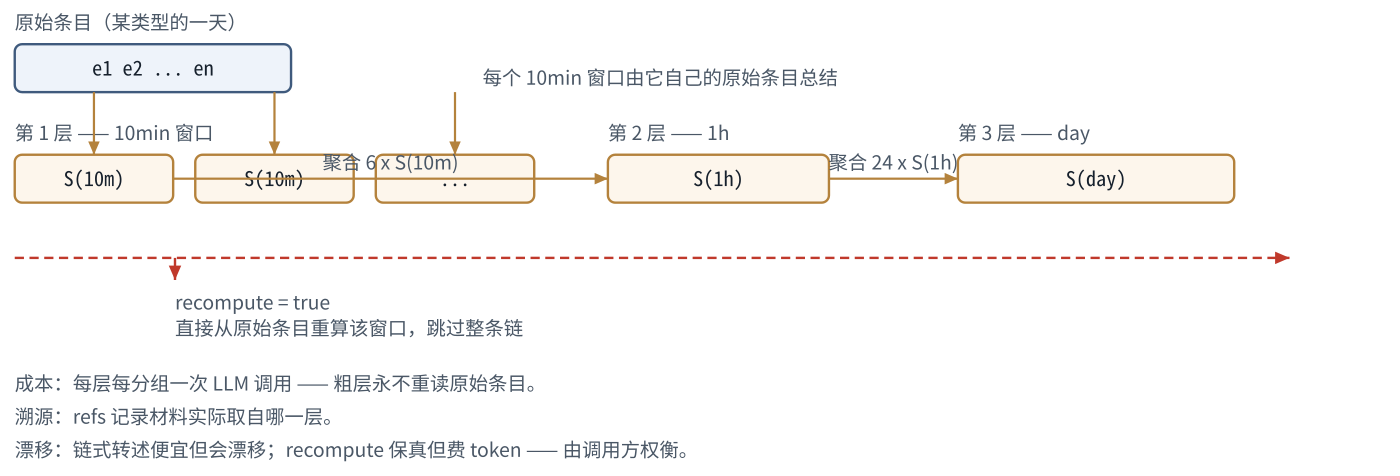
图 2 · 自底向上的递归总结。每一层由它下面一层总结而来;更细层缺失时按需现算;recompute 绕过链条、直接从原始条目重建窗口。每条摘要本身都是 append-only,链条上没有任何东西被销毁。
原始条目 → S(10min) → S(1h)
        → S(day) → S(week)
这就是结构塔在语义上的对应物,实现了递归、非破坏的压缩——链条上没有任何东西被销毁。
而且总结默认自底向上:在总结一个粗窗口之前,服务会先确保它内部每个更细子窗口都有摘要(缺的按原始条目先补出来),再用这些子摘要聚合。好处是粗粒度总结的成本是「每个分组一次调用」,而不是把整个窗口重读一遍。
摘要记录里除了内容,还存了生成口径:{strategy, chunks, inputTokens, clippedEntries}——记录这次是一步直连产出还是分块 map-reduce 聚合、以及为预算截断了多少条目。这类字段平时不起眼,出问题时是唯一能定位的东西。
想绕开链条也行:recompute 直接从原始条目重算该窗口,跳过整条链。链式转述便宜但会漂移,重算保真但费 token——把这个权衡交给调用方,而不是替它悄悄选一个。
五、语义总结的五道护栏
前面说语义总结会「悄悄烧 token」,这不是假想。所以忆时塔把它做成按类型 opt-in(新建类型默认关闭),开启后用五道护栏约束:
- 只总结最近一个已闭合窗口,且有沉降期——窗口还在被写入时,绝不总结;
- 按窗口、按分组幂等,成功即清空重试账;
- 空窗口零成本,直接跳过;
- 连续失败会退避,到达上限后登记为「已放弃」并留痕——而不是每十分钟永远重试;
- 每轮提交数有上限,积压不会变成无界突发。
内置的 worklog 类型开箱即用(每个已闭合的自然日、每个项目一条摘要),任意新建类型默认关闭。回想时遇到「摘要缺失」也是显式路径(summarize_on_miss),不偷偷替你算。
六、为什么做成 MCP 服务
忆时塔不是库,是一个常驻守护进程,只暴露一个 streamable-HTTP MCP 端点。任何支持 MCP 的客户端都能接入:
// opencode.json
{ "mcp": { "chronomem": {
    "type": "remote",
    "url": "http://127.0.0.1:8900" } } }
我认为把记忆做成协议而不是私有库,本身就是系统层面的贡献:异构工具可以共享同一个记忆底座,而它们之间零代码耦合。今天用 opencode 干活、明天换 Cherry Studio 聊天,记忆是同一份。
存储上是单一时序数据库,每个记忆类型占两个 series——原始条目一个,摘要一个。类型可以自己建,名字白名单 [A-Za-z0-9_/-](防路径穿越),比如:
worklog          工作日志
proj/decisions   项目决策
tool/errors      工具报错
工具面目前是 13 个 mem/*,覆盖类型管理、追加、结构回想、语义总结、以及总结任务的异步状态查询。
七、和别的记忆系统差在哪
这块得说实话:忆时塔的每个组件都借自别处。
- 分层时间窗 + 物化聚合是时序数据库的标配(TimescaleDB 连续聚合、Prometheus 降采样),忆时塔基于自研的
tsdb库复用了这套机制; - 分层记忆管理不是新想法(MemGPT 引入分层上下文;Generative Agents 把记忆流与反思结合;A-MEM、Mem0、HiMem 等各有发展);
- 明确区分「精确回想 vs 语义回想」作为显式成本模型、摘要是一等公民时序条目、以及把整个底座标准化在 MCP 后面——这三条是我的差异点。
还有一条轴值得单独说:主题记忆 vs 时间记忆。
「LLM wiki」那类系统按主题/语义词条组织知识,类比维基百科——把来源编译成一份由 LLM 持续维护的持久 wiki。忆时塔按时间组织,类比账本。这两条轴是互补的,不是竞争的:
论文是「过程」(时间),参考手册是「知识体」(主题)。
我认为很多「记忆」系统把这两条轴混为一谈了,而轴的选择应该跟随用途——你要回忆的是「这件事怎么发生的」,还是「这个东西是什么」?
八、哪些做完了,哪些没做
写设计文章最容易犯的错,是把「设计」讲得像「已实现」。所以逐条标清楚:
| 组件 | 状态 |
|---|---|
| 记忆类型、类型级粒度链 | 已实现(运行时动态,加类型不用改码) |
| 日历对齐的自然窗口(day/week/month,时区可配) | 已实现 |
引用链物化 + exact 下钻(服务端零 LLM) |
已实现 |
| 语义摘要 + 递归自底向上总结 | 已实现(recompute 可绕链条) |
| 带护栏的定时自动总结 | 已实现(沉降/幂等/退避/每轮上限) |
MCP 工具面(13 个 mem/*) |
已实现 |
| 内嵌 Web 控制台(与 MCP 同端口) | 已实现 |
| 会话活动自动采集 | 已实现(宿主插件形式随仓分发) |
| 数值聚合(指标型零 LLM 概览层) | 规划中(当前只有 count/latest/sample) |
| 保留期 / 淘汰 | 规划中(类型可声明,但不生效,实际全量保留) |
| MCP resources | 规划中(目前只有 tools) |
| 鉴权、加密、多租户 | 规划中(当前单用户、仅本机) |
两处我觉得必须主动交代的局限:
一致性受物化边界约束。 粗粒度视图只反映到它上次物化为止的记录,之后写入的条目不在其中。它会返回一个陈旧但自洽的窗口——看上去完全合理,不带任何错误信号。所以我把「物化视图的一致性」当成待测量的显式属性,而不是默认成立的前提。
保留期只是声明式的。 类型元数据里能声明保留窗口,但没有任何机制执行它——实际是全量保留。
九、下一步
position 论文以一份评估计划收尾,没有任何结果:受控的长周期 Agent 任务对照、沿摘要链的语义漂移研究、以及我自己部署上的工作日志用例。
那部分我已经执行完了——结果里最有意思的不是忆时塔表现多好,而是我最初的测量方法错了两次,且错到会把结论反转。
下篇讲实测:近因基线的失效为什么是断崖而非衰减、为什么「周摘要和天摘要逐字节相同」意味着根本没压缩、盲测 6/6 背后是什么、以及两个让结论反向的测量陷阱和一个关于 LLM 判定者的负面结果。